Projet universitaire — Complété
Inférence causale — Tabagisme et qualité du sommeil
Étude du tabagisme et du sommeil sur 297 584 observations analysées, avec Double Machine Learning.
Le point de départ
Étudier le lien entre tabagisme et qualité du sommeil en distinguant l’association brute d’une estimation ajustée. La question centrale est le rôle des facteurs de confusion dans l’interprétation des résultats.
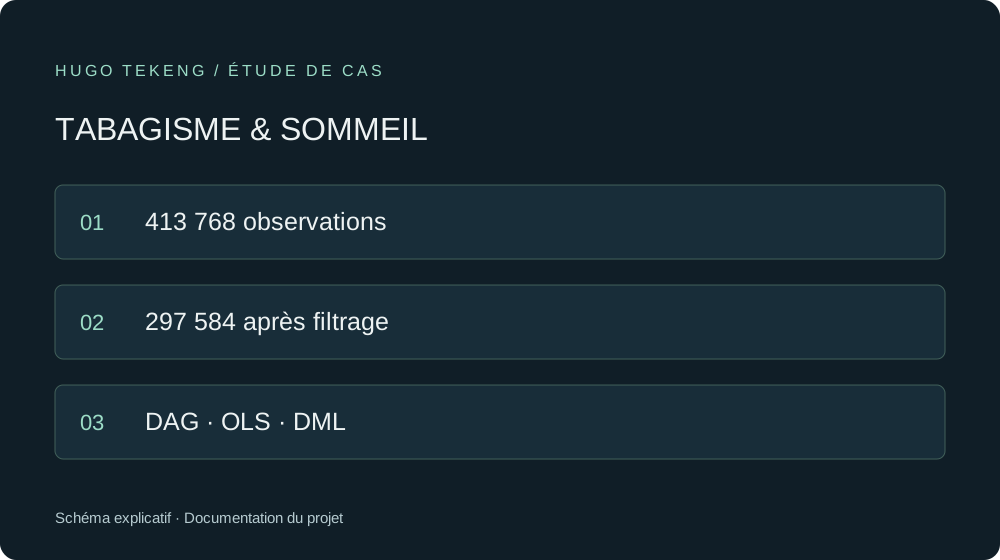
À partir d’un jeu initial de 413 768 observations, analyse de 297 584 observations après exclusion des anciens fumeurs. Comparaison de la différence brute, d’une régression OLS et du Double Machine Learning. L’interprétation causale reste conditionnelle aux hypothèses du graphe causal et à l’ajustement des facteurs de confusion.
Comment cela fonctionne
- 1413 768 observations
- 2Filtrage & préparation
- 3DAG & ajustement
- 4Différence brute · OLS
- 5DML · cross-fitting
Architecture & mise en œuvre
- Nettoyage et filtrage du jeu initial : 413 768 observations, 297 584 analysées.
- Formalisation d’un DAG et choix des variables d’ajustement.
- Comparaison de la différence brute et d’une régression OLS.
- Double Machine Learning avec Random Forest et cross-fitting en cinq plis.
Choix techniques
- Random Forest pour les relations non linéaires dans les modèles de nuisance.
- Cross-fitting en cinq plis pour séparer apprentissage des nuisances et estimation.
Enseignements
- La proximité des estimations OLS et DML ne prouve pas à elle seule leur validité causale.
- Un graphe causal explicite rend les hypothèses discutables et vérifiables.
Pistes d’évolution
- Tester des méthodes causales supplémentaires (DiD, variables instrumentales).
- Enrichir l'analyse avec des confondeurs supplémentaires (stress, activité physique).
- Étudier l'hétérogénéité de l'effet causal par sous-groupes.
Résultats & apport concret
- Construction d’une démarche reproductible : définition de la population, formalisation des hypothèses et comparaison de trois approches.
- Double Machine Learning construit avec des modèles Random Forest et un cross-fitting en cinq plis.
- Apport professionnel : expliquer pourquoi une corrélation ne suffit pas à guider une décision causale.
Ce qui est réalisé
- Rapport et code produits.
- Trois approches comparées : différence brute, OLS et DML.
- Les estimations doivent être interprétées en tenant compte des hypothèses d’identification et des facteurs non observés.
Portée & limites
- Les résultats dépendent du DAG, des variables observées et des hypothèses d’identification. Des facteurs non mesurés peuvent modifier l’interprétation.
- Aucun intervalle de confiance DML n’est présenté dans le livrable analysé. L’étude reste académique et ne constitue pas une recommandation médicale.
Source : rapport et notebook du projet d’inférence causale. Effectifs après filtrage ; aucune estimation de résultat clinique ou commercial.