Projet universitaire — Terminé
EEG et état des yeux
Classification de l’état des yeux sur signaux EEG et analyse causale, avec évaluation chronologique.
Le point de départ
Peut-on prédire l’état ouvert ou fermé des yeux à partir de signaux EEG ? Et cette capacité prédictive permet-elle d’établir un effet causal sur l’activité cérébrale future ? Deux questions étudiées séparément.
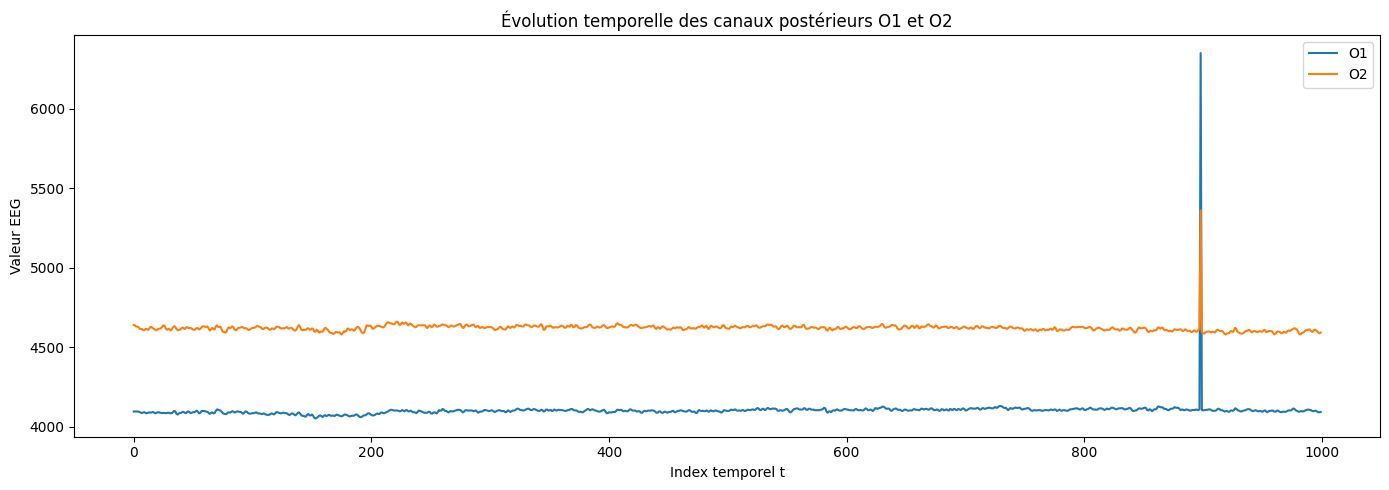
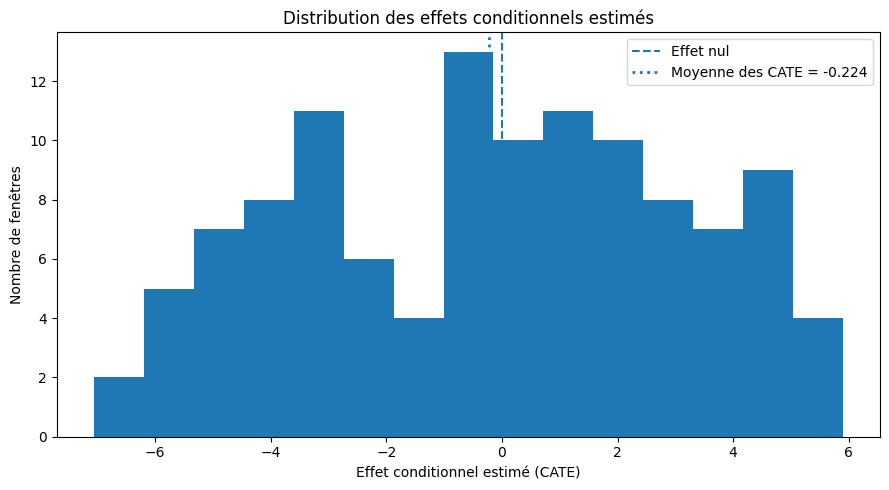
Analyse de 14 980 observations sur 14 canaux EEG, segmentées en 117 fenêtres de 128 observations. Comparaison de modèles prédictifs et étude de l’effet de la fermeture des yeux sur l’activité EEG future. Les résultats causaux ne mettent pas en évidence d’effet statistiquement significatif.
Comment cela fonctionne
- 114 980 mesures · 14 canaux
- 2Fenêtres de 128 mesures
- 3Découpage chronologique
- 4Modèles & évaluation
- 5Analyse causale distincte
Architecture & mise en œuvre
- Préparation des signaux et segmentation en fenêtres de 128 observations.
- Séparation chronologique : 78 fenêtres d’entraînement, 15 de validation et 24 de test.
- Comparaison de la régression logistique, de Random Forest et d’un Transformer Encoder.
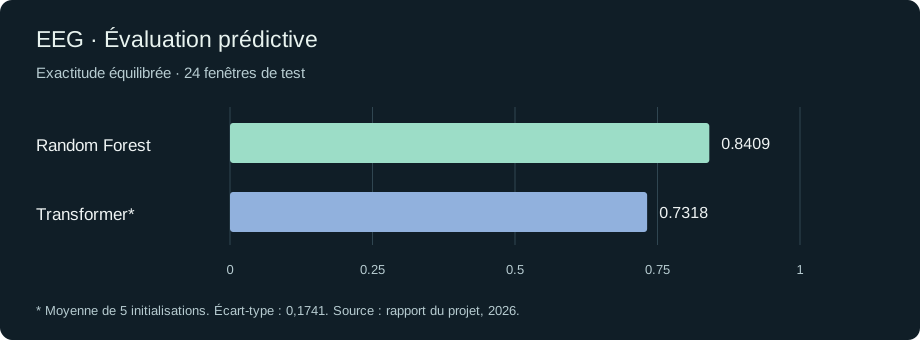
- Évaluation par ROC-AUC, F1 macro et exactitude équilibrée ; cinq initialisations pour le Transformer.
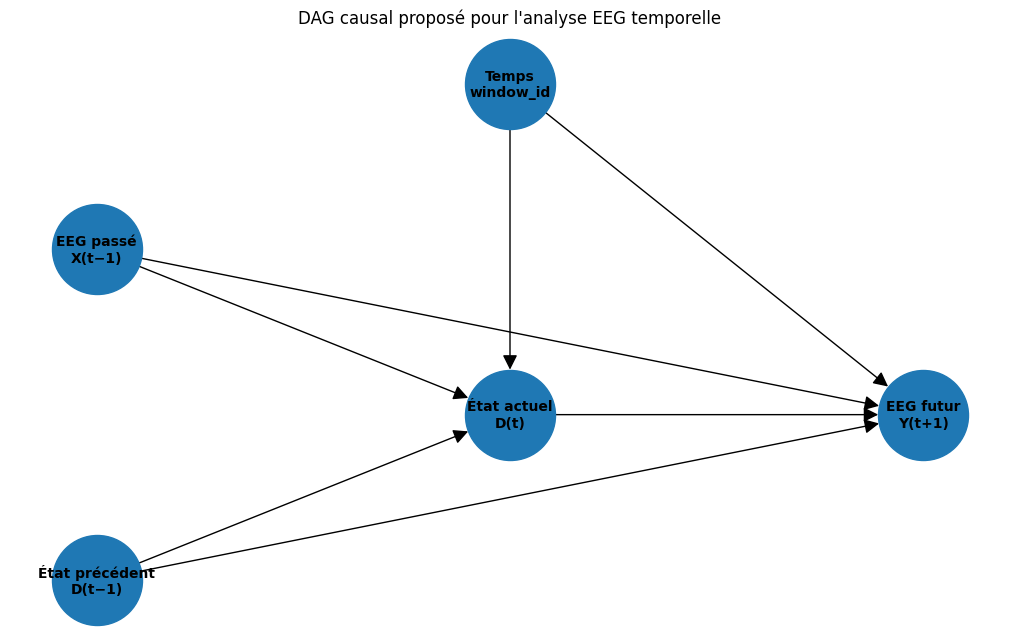
- Estimation causale par régression avec erreurs HAC et CausalForestDML.
Choix techniques
- Respecter l’ordre temporel et ajuster le prétraitement sur les données d’entraînement.
- Comparer des modèles simples et un Transformer.
- Rapporter la variabilité et les limites liées au faible effectif de test.
Enseignements
- Une capacité prédictive ne constitue pas une preuve de causalité.
- Le déséquilibre des classes et le faible effectif de test limitent la portée des métriques.
Pistes d’évolution
- Étendre l'analyse à plusieurs enregistrements EEG pour renforcer la généralisation.
- Tester des architectures deep learning plus complexes (GRU, CNN 1D).
- Explorer des méthodes causales supplémentaires (DiD, IV).
Résultats & apport concret
Résultats prédictifs sur le jeu de test
| Modèle | ROC-AUC | Exactitude équilibrée | F1 macro |
|---|---|---|---|
| Random Forest | 0,9318 | 0,8409 | 0,5872 |
| Transformer (moyenne de 5 essais) | 0,8545 | 0,7318 | 0,5189 |
Écarts-types du Transformer : ROC-AUC ±0,2207 ; exactitude équilibrée ±0,1741 ; F1 macro ±0,2146. Seulement 24 fenêtres de test, dont 2 yeux fermés. Ces résultats descriptifs ne démontrent pas une fiabilité clinique.
Une évaluation chronologique
78 fenêtres d’entraînement → 15 de validation → 24 de test. L’ordre temporel est conservé.
- Comparer un modèle profond à des modèles tabulaires plutôt que supposer qu’il sera meilleur : Random Forest obtient ici une meilleure exactitude équilibrée que la moyenne du Transformer.
- Documenter une conclusion négative utile : aucun effet causal statistiquement significatif n’a été mis en évidence dans cette analyse.
- Compétences transférables : préparation de séries temporelles, prévention des fuites de données et communication de l’incertitude.
Ce qui est réalisé
- Analyse et rapport terminés en 2026.
- Transformer : ROC-AUC moyenne 0,8545 et exactitude équilibrée moyenne 0,7318 sur cinq initialisations.
- Jeu de test limité à 24 fenêtres, dont seulement deux dans la classe yeux fermés : résultats à interpréter avec prudence.
- Aucun effet causal statistiquement significatif détecté dans cette analyse.
Portée & limites
- Le test comporte seulement 24 fenêtres, dont 2 avec les yeux fermés. Les métriques sont donc fragiles et ne prouvent pas une généralisation clinique.
- Transformer : cinq initialisations ; les écarts-types reflètent leur variabilité, pas un intervalle de confiance sur une population.
- Aucune application médicale ni mesure d’impact en entreprise n’a été validée.
Source : rapport et notebook du projet EEG, 2026. Valeurs reproduites à partir des résultats enregistrés ; modèles non réentraînés pour ce portfolio.