Projet académique — Data & Machine Learning
Projet dépression
Application Flask/MongoDB, recherche sémantique et analyses sur 19 999 enregistrements.
Le point de départ
Associer gestion de données, recherche sémantique et exploration statistique sur un jeu de données lié à la dépression. Le projet permet de travailler à la fois le développement d’une application et l’évaluation critique de modèles.
Projet universitaire associant une application de gestion de données Flask/MongoDB Atlas et des scripts distincts d’analyse. Exploration, segmentation K-means, ACP, classification et régression sont complétées par une recherche sémantique MiniLM. Il s’agit d’un exercice analytique, sans outil de diagnostic clinique.
Comment cela fonctionne
- 1Données MongoDB Atlas
- 2Application Flask · CRUD
- 3Embeddings MiniLM
- 4Recherche sémantique
Architecture & mise en œuvre
- Application Flask avec opérations CRUD sur MongoDB Atlas.
- Recherche sémantique à partir d’embeddings MiniLM.
- Scripts d’analyse distincts : exploration, K-means, ACP, classification et régression.
Choix techniques
- Flask pour une architecture légère et adaptée à un projet analytique web.
- MongoDB Atlas pour la flexibilité de stockage et l'intégration simple avec les pipelines.
- Séparation claire entre gestion des données, analyse statistique, modélisation et visualisation.
- Recherche sémantique pour aller au-delà d'une simple interface de consultation.
Enseignements
- Un projet data pertinent demande autant de rigueur en gestion des données qu'en modélisation.
- La visualisation joue un rôle clé pour rendre les résultats interprétables.
- Une interface web analytique rend un projet scientifique beaucoup plus exploitable.
Pistes d’évolution
- Améliorer l'interface pour rendre l'exploration plus intuitive.
- Renforcer la comparaison entre modèles de machine learning.
- Documenter davantage les pipelines et hypothèses analytiques.
Résultats & apport concret
- Une application permet de consulter et gérer les données ; les embeddings ajoutent une recherche fondée sur le sens du texte.
- Des scripts distincts explorent les groupes par K-means/ACP et évaluent des tâches de classification et de régression.
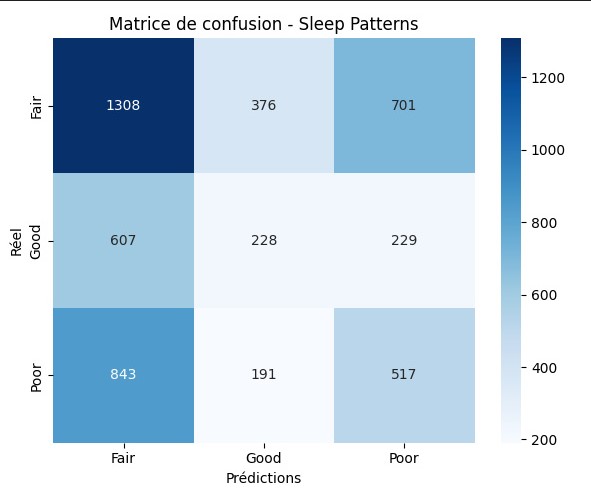
- La comparaison à une référence simple fait partie du résultat : le modèle de sommeil n’améliore pas la référence majoritaire sur l’exactitude.
Ce qui est réalisé
- Application de gestion des données et recherche sémantique fonctionnelles.
- Analyses réalisées sur 19 999 enregistrements dans des scripts distincts.
- Performances des modèles comparées aux références, avec discussion de leurs limites.
Portée & limites
- Les analyses prédictives sont des scripts distincts, pas des fonctionnalités toutes intégrées à l’application web.
- Ce projet ne réalise pas de diagnostic de dépression et ne valide aucun usage clinique.
Source : code et rapport du projet de gestion des entrepôts de données, 2025. Schéma du parcours applicatif ; les analyses statistiques sont exécutées séparément.